GLM-5.3-Flash 从全新基础模型开始训练,并围绕模型能力与推理效率重新设计架构和训练方法。它首次在 GLM 系列中引入稀疏注意力与线性注意力相结合的混合架构,并采用 Manifold-Constrained Hyper-Connections(mHC,流形约束超连接)提升扩展效率。结合最新的 30T Token 多模态预训练语料,模型能够以更少的计算资源获得更高的能力密度。
正式发布前,GLM-5.3-Flash 曾以 Ox Alpha 的匿名名称接受真实用户检验,相关流量由国产 AI 芯片提供服务。
面向极致效率的模型架构
GLM-5.3-Flash 的架构专门针对低成本、高效率推理设计。与总参数量相近的 GLM-4.5 系列相比,其激活参数量从 32B 降低至 18B,模型层数从 92 层降低至45 层。
为了降低长上下文场景中的注意力成本,GLM-5.3-Flash 采用线性注意力与稀疏注意力结合的混合架构。线性注意力通过状态建模捕获局部依赖,稀疏注意力则利用轻量级索引器召回相关的全局上下文。
在最高 1M Token 上下文下,模型进一步引入 IndexPool,通过加权池化将四个索引器 Key 向量压缩为一个,从而降低索引器带来的延迟和内存开销。
按照智谱公布的对比结果,GLM-5.3-Flash 相较 GLM-5.3:
- 注意力计算量实现约 3.01× reduction;
- KV Cache 大小实现约 4.44× reduction。
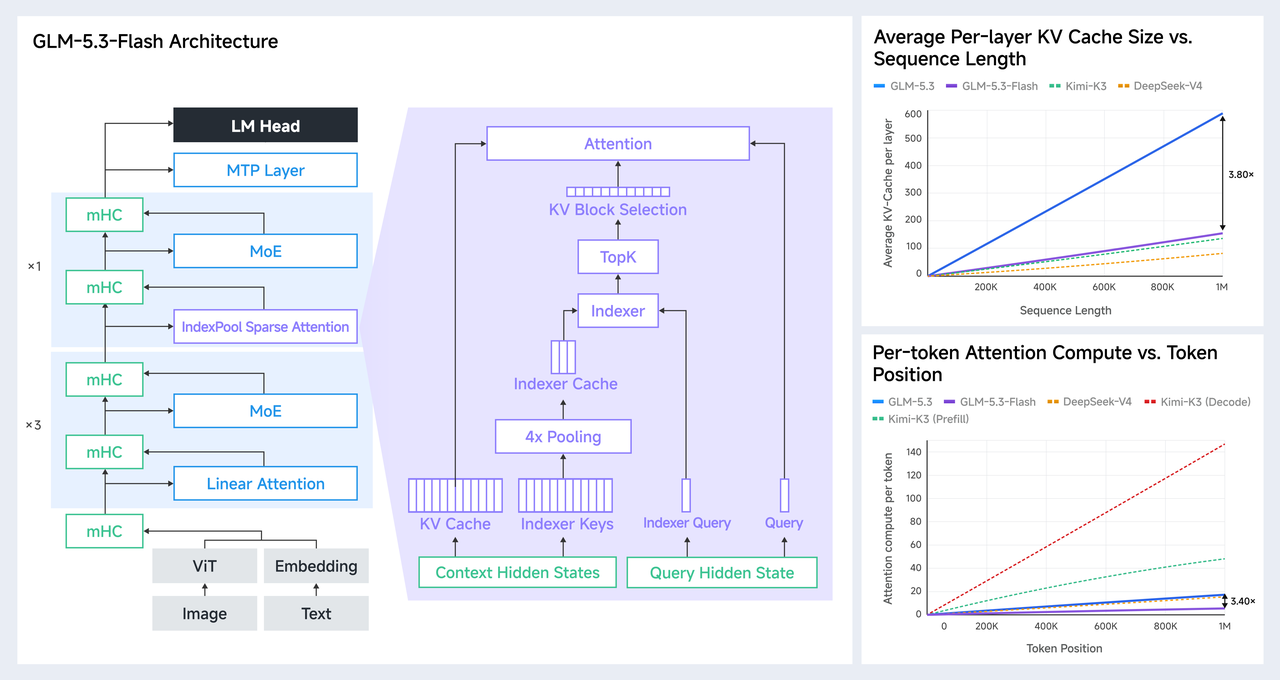
在官方对比的多款模型中,GLM-5.3-Flash 具有最低的注意力计算量。其 KV Cache 占用仍略高于部分同类 Flash 模型,相关架构仍存在进一步优化空间。
这些架构升级与多模态训练语料相结合,使 GLM-5.3-Flash 能够以更少计算处理长上下文、复杂推理和多步骤任务。
复杂任务与 Agent 能力
在智谱公布的官方评测中,GLM-5.3-Flash 在编程、工具使用、任务自动化和专业工作等多项 Benchmark 上超过 GLM-5.2。
| 评测 | GLM-5.3-Flash | GLM-5.2 |
|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 |
| DeepSWE v1.1 | 63.4 | 46.2 |
| NL2Repo | 56.3 | 48.9 |
| Toolathlon Verified | 78.4 | 59.9 |
| AutomationBench v1.0.6 | 48.8 | 26.2 |
| Agents’ Last Exam | 26.3 | 20.4 |
| HLE with Tools | 55.3 | 54.7 |
| GDPval-AA v2 | 1773 | 1504 |
这些评测覆盖了任务理解、规划、工具调用、环境反馈处理和多步骤执行等底层能力。它们不仅服务于软件开发,也能够支持研究分析、文件处理、数据整理、内容生产和业务流程自动化等更广泛的工作。
原生多模态与视觉智能
GLM-5.3-Flash 从预训练阶段统一学习文本和视觉信息,能够理解文本、图片、视频和文件。
原生多模态能力使模型不仅可以识别视觉内容,还能理解文档结构、图表信息、界面状态、布局关系和操作反馈,并将视觉信息用于后续推理和任务执行。
在智谱公布的视觉评测中,GLM-5.3-Flash 在多个专业视觉任务上取得了较强表现:
| 评测 | GLM-5.3-Flash |
|---|---|
| OfficeQA Pro | 62.4 |
| CharXiv Reasoning with Tools | 89.4 |
| Chartography with Tools | 78.0 |
| BabyVision | 53.4 |
| MVBench | 77.8 |
| MMVU | 80.5 |
让视觉反馈进入任务循环
视觉理解的价值不只是识别图片,而是让模型能够观察工作结果,并根据实际呈现继续判断和调整。
- 在文档和演示文稿任务中,模型可以查看最终渲染页面,检查信息层级、图表表达、图片裁切、页面对齐和整体风格,并根据发现的问题继续修改。
- 在数据分析任务中,模型可以同时理解数据和图表呈现,判断图表是否准确表达结论、数据口径是否一致,以及关键信息是否得到突出。
- 在产品与界面任务中,模型可以观察网页或应用的实际状态,理解页面结构、操作流程和反馈结果,并将视觉发现转化为体验分析、修改建议或后续任务。
在包含多个执行步骤的工作流中,模型还可以通过观察工具返回的界面和结果,确认操作是否成功,并决定下一步行动。视觉信息由此成为任务执行和结果验证的一部分。
面向专业工作的多模态能力
大量专业工作都需要处理包含视觉和结构信息的材料,例如文档、表格、演示文稿、数据看板、产品界面和会议材料。
GLM-5.3-Flash 可以围绕复杂目标拆解任务、调用工具、检查结果并继续优化,完成从材料理解、研究分析到专业成果交付的完整过程。
- 在 Office 场景中,模型可以处理 PPTX、PDF、DOCX 和 XLSX 等常见文件。它不仅关注内容,也可以根据渲染结果检查信息结构、视觉风格、图表、图片裁切和页面排版,发现文字溢出、元素错位、相互遮挡和样式不一致等问题。
- 在研究与分析场景中,模型可以整理公开资料、业务文件和结构化数据,区分已知事实、分析假设与推断结论,并将信息进一步组织成报告、数据分析、演示文稿或其他专业成果。
- 在会议和协作场景中,模型可以结合会议材料、记录和已有文件,梳理讨论内容、待办事项与决策依据,并继续形成可执行的工作计划和后续交付。
在国产 AI 芯片上规模化运行
GLM-5.3-Flash 曾在大规模国产 AI 芯片集群上承载真实用户流量。针对单芯片内存容量和带宽限制,智谱围绕模型架构构建了专门的推理引擎。
相关技术栈包括线性注意力与 LM Head 的节点内张量并行、ReplaySSM、W8A8 量化、INT8/FP8/BF16 混合缓存量化、Layer Split,以及将多模态编码、Prompt Prefill 和逐 Token 解码分别调度的 Encode–Prefill–Decode 分离式服务架构。
根据智谱公布的数据,与同一硬件上的初始基线相比,经过优化后的端到端服务性能提升约三倍。
GLM-5.3-Flash 的效率来自模型架构、多模态训练数据、推理引擎和底层硬件的共同优化,而不是单一技术带来的结果。
开放权重与部署
GLM-5.3-Flash 的模型权重已在 Hugging Face 公开,并采用 MIT License。
根据官方发布信息,模型支持 SGLang、vLLM 和 TokenSpeed 等推理框架。具体框架兼容性和部署要求可能持续更新,应以官方模型仓库的最新说明为准。
现在,你可以在 AutoClaw 中使用 GLM-5.3-Flash,让高效的原生多模态智能进入真实工作流。