

AI 金融工具榜单值不值得信?看这四件事就知道
榜单没有变差,是它证明的东西变了。
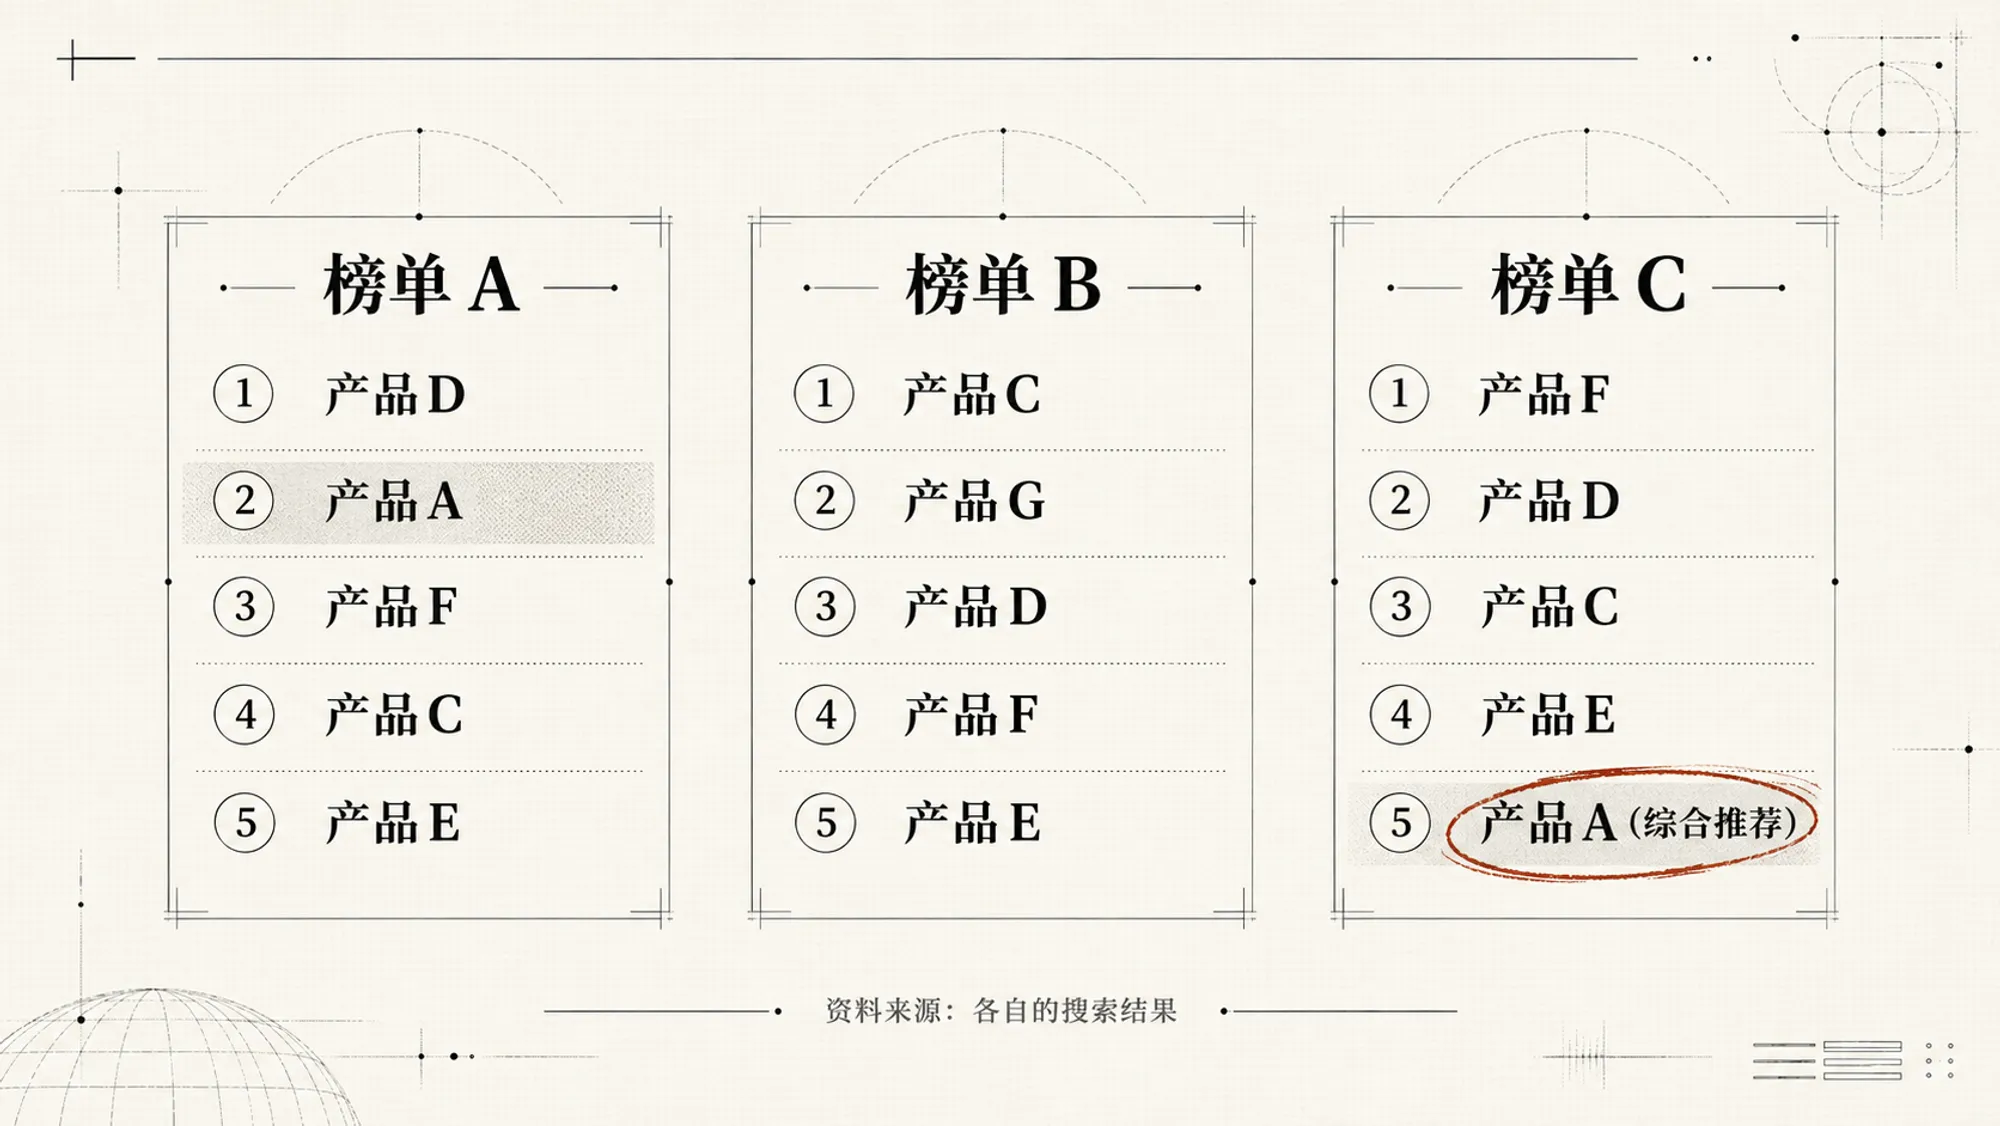
如果你打算搜「AI 金融工具哪个好」,翻过两屏之后,大概会看到五六份榜单。如今「AI 金融工具评测」这个词下的搜索结果,基本都是这个形态:它们排的不是同一批产品,排名也互相打架——同一款工具,在 A 榜排第二,在 B 榜落选,在 C 榜却成了「综合推荐」。每份榜单都带评分,甚至精确到小数点后一位。你翻完,多知道了一些产品名,却仍然不知道选哪个。
有人已经把这种体验写成了结论:「这些榜单都不可信了」「AI 金融工具是不是智商税」。但「不可信」这个结论太省事了,它让你连一份能用的榜单也一起丢掉。还有一层更隐蔽的问题:很多榜单本来就是软文,它不是在帮你横向对比,而是在帮某款工具「恰饭」。但你很难从版面上看出来,因为软文和评测长得一模一样。
一份榜单值不值得信,取决于它证明的是什么。以前它证明的是「很多人用过」,现在它证明的是「谁投喂得多」,这中间变的是供给,不是质量。
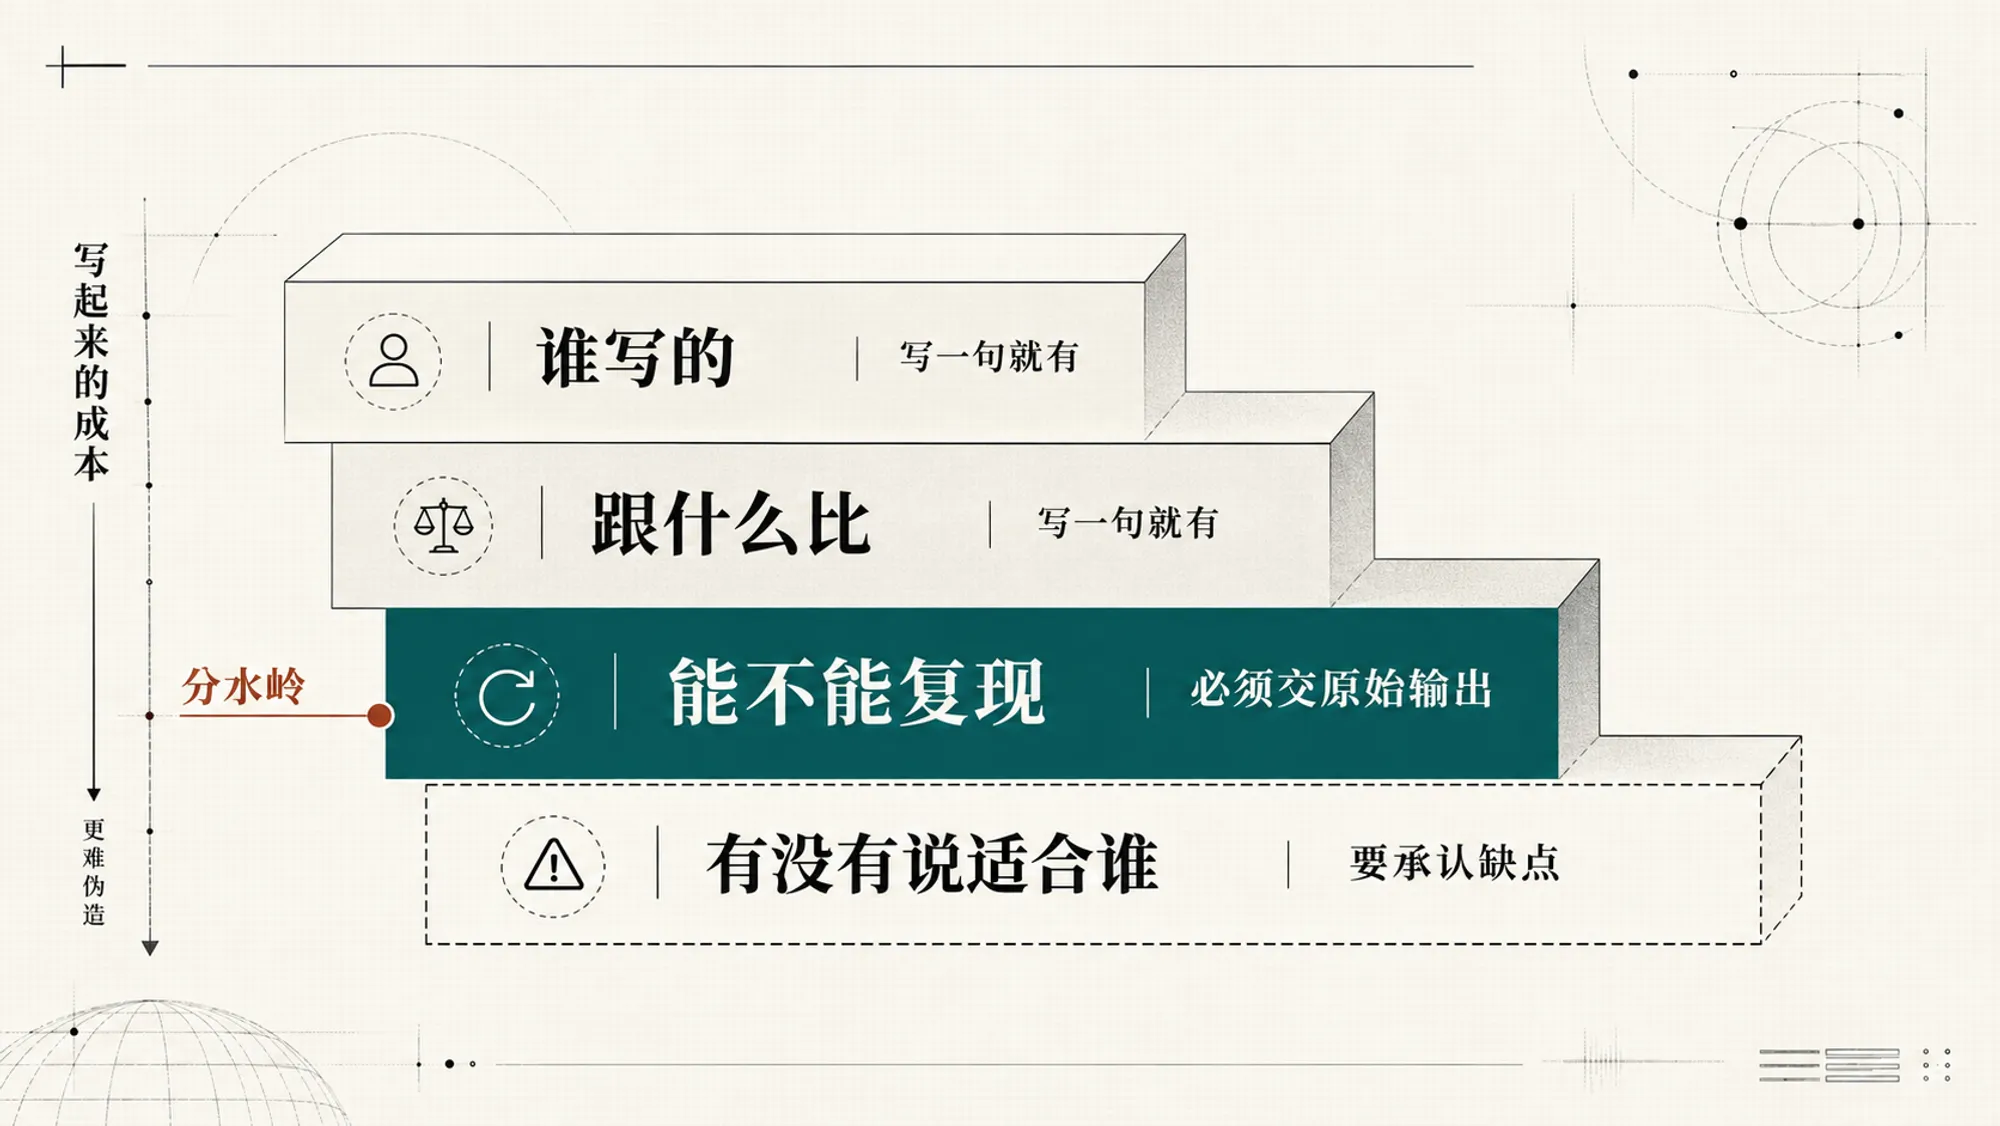
那么,AI 金融工具评测到底怎么看?看四件事:谁写的、跟什么比、能不能复现、有没有说「不适合谁」。四件都答得上来,这份榜单可以用;缺两件以上,它只是一份带评分的广告。
榜单曾经值得信,因为它证明了一件很简单的事
榜单曾经值得信,因为它证明了一件很简单的事。
在没有 AI 的年代,一份金融工具榜单的价值不在「分析得对」,而在「真的用过」。终端、数据接口、研报库,这些东西个人用不起,试用期短,报价还得谈。你没法自己比,只能信一个用过的人。作者是谁其实不重要,重要的是他花的是自己的时间,用的是你没有的权限。
那个年代的榜单圈子小、更新慢,但证据结构是成立的:一个人用了三个月,把踩过的坑写下来,你拿着这份记录去避坑。
问题在于,这个结构成立的前提是「做榜单很贵」。
现在不值钱,不是写的人变懒了,是写的成本塌了
一份看起来专业的横评,今天可以一天生成二十份。
要做的只有三步:搜"AI 投研工具 推荐",抓前二十篇文章;让模型把里面的产品名、功能描述、价格整理成表格;给每一栏编一个总分,配上"综合实力强""体验流畅"这种不给依据的评语。剩下的,是找地方发出来——有些发在内容平台,有些直接就是厂商自己的"软文"通道,读者分不出来。
于是出现了两个可以观察到的后果。
第一,同一批产品在不同榜单里排名不同。 不是有人测得细、有人测得粗,是每份榜单的"资料源"不一样——哪篇文章先被搜到、被引得多,哪个产品就在那张表里靠前。
第二,榜单的格式越来越像权威,内容越来越像参数抄写。 三列变五列,评分从星级变百分制,还加了雷达图。但表格里几乎没有一行是作者自己测出来的:功能项抄的是官网,价格抄的是营销页,"适用人群"抄的是上一份榜单。
这两件事合起来,指向同一个变化:榜单的供给变了。 从"少数人花时间测"变成"多数人花几分钟拼"。而评价一份榜单时最容易犯的错,就是只看它的样子——排版、评分、结论——不看它的证据。
AI 金融工具评测能不能用,看四件事
这四条不需要你是行业内行,也不需要你测过产品。它们检查的是"这份榜单有没有留下证据",不是"它说得对不对"。
表 1|四件事:合格的回答与不合格的信号
| 看什么 | 合格的回答长什么样 | 不合格的信号 |
| 谁写的 | 署名到人,能查到这个人做过什么、有没有利益关系 | 只有品牌名、没有作者;文末写"本文由 XX 提供" |
| 跟什么比 | 说清比较的是同一个任务、同一批问题、同一天取数 | 只比功能项和价格;不同产品的数据取自不同月份 |
| 能不能复现 | 给出原始提问或原始输出,别人照做能得到相近结果 | 只给结论和评分,不给测试过程;"实测"两个字没有任何截图 |
| 有没有说"不适合谁" | 明确写出什么情况下别用这款 | 全是优点,缺点写成"还有提升空间" |
四件事里,第三件最关键,也最容易被跳过。
因为前三条都能"写"出来——作者可以署名、可以写"同一批问题"、可以说"我测了三十天"。只有第三条要交东西:把你的测试过程交出来,让别人能照着做一遍。
一份榜单如果连"我们问了什么"都不肯给,那它给出的所有分数,都只是一个自称。
两分钟能问出来的三件事
不用发邮件,也不用联系作者。打开榜单,在页面上找三样东西:
找"我们怎么测的"。 通常在正文前 60% 或者文末。有这一段,四件事里前两条基本能判断;没有这一段,直接降级。
找原始输出。 任何一份真做过测试的榜单,都会忍不住贴截图——因为那是它最值钱的部分。一张原始截图能抵三百字描述:你能看到提问原文、看到模型回答、看到它对在哪里错在哪里。
找"不适合"。 全文搜"不适合""别买""不推荐"。这个词出现的位置,比它的结论更有信息量。
三样都找一遍,大概两分钟。两分钟换掉一个错误的工具选型,是这笔账里最划算的部分。
四种一眼假的横评,长什么样
下面四种,是从实际搜索结果里归纳出来的形态。它们的共同点是:排版很像评测,证据为零。
第一种,参数抄写成对比表。 表头是"功能 / 数据覆盖 / 价格 / 评分",每一栏都填得很满。但你逐格看下去会发现,功能项和官网一字不差,价格和营销页一致,评分没有权重说明。这张表唯一没抄的东西,是"评分"——而它恰好是这张表唯一看起来像判断的部分。
第二种,评分不给权重。 总分 92 分,但 92 是怎么来的没人说。数据覆盖占多少、准确率占多少、易用性占多少,一个字不提。没有权重的分数不是结论,是排序工具——它想让谁排第一,就可以把对谁有利的那一项权重调到 40%。
第三种,只测顺手的任务。 所有 AI 工具都比同一个简单任务:让它总结一份财报、问它一个常识问题。这类任务现在的模型大多能过,所以大家都拿高分。真正区分工具的是难任务——跨期比较、口径不一致、数据缺失时它怎么办。你拿它当 AI 选股工具用,它测的却是"能不能读一段年报摘要";你拿它当 AI 写研报的助手,它测的却是"能不能回答一个百科问题";你拿它当 AI 读财报工具,它测的是"能不能总结一段text"。工具的实际场景和测试场景之间差了一整层活,但榜单不会告诉你这件事。
第四种,结论和数字不咬合。 表格里 A 在四项有三项领先,最后"综合推荐"给了 B,理由是"生态更完整"。这个理由可能是真的,但它不在表格里——当结论超出证据范围时,超出的那一部分就是立场。 你去看那些"同花顺 vs 萝卜投研""DeepSeek vs 豆包 哪个适合金融"的对比文,大多数落在这个形态里:数字给了一半,结论跳到了另一半。
判断这四种形态有个通用办法:看它有没有交出原始输出。 交不出的,前面三条再漂亮也只是版式。这四种形态和 AI 编东西的痕迹其实是一回事:[AI 幻觉怎么发现](10-AI幻觉怎么发现.html)里讲过三个破绽——数字精确到可疑、出处查不到、什么都答得出来。一份榜单如果同时具备这三条,它和一段编出来的文字没有区别,只是排版更好。
那还要不要看榜单
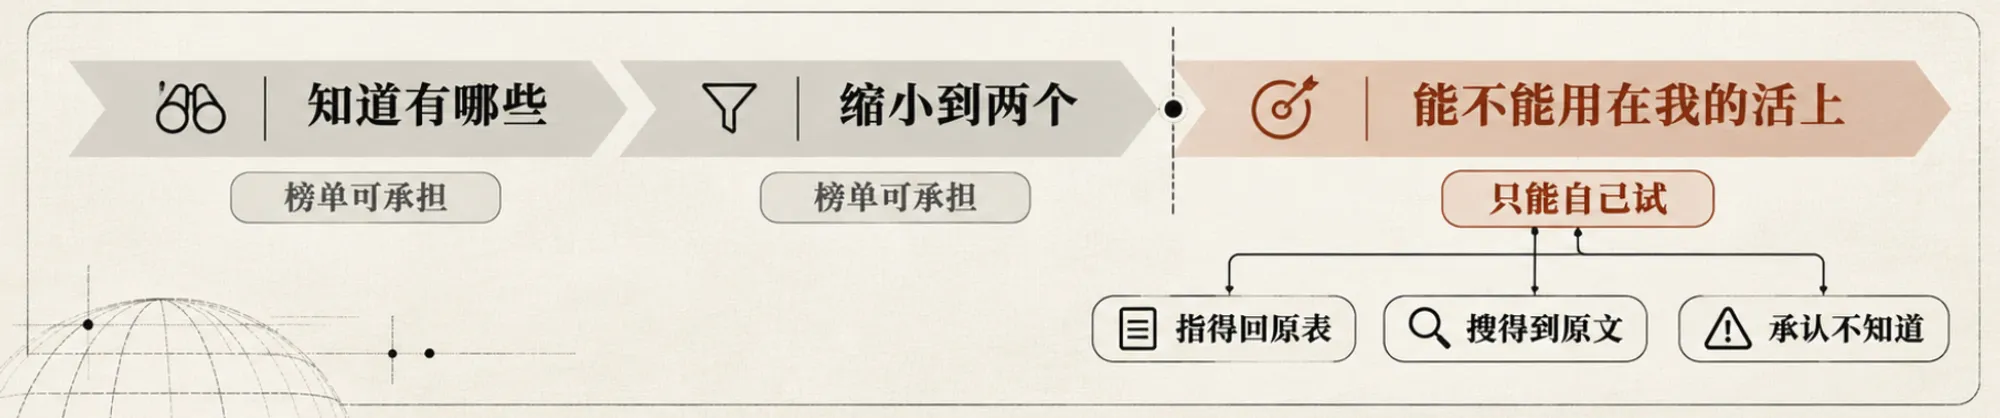
要,但只用它做一件事:缩小候选范围,不做最终决定。这是榜单真正还能承担的功能。它至少能告诉你这个赛道有哪些玩家、大致分几类、价位分布在哪个区间。这些信息你自己从零搜,要花掉一整个下午。
但它不能替你做的,是判断哪一款适合你的活。原因很简单:你的活它没测过。你做的是季报点评、同业对比、定期跟踪,它测的是"总结一份财报"。你想要的是一个 AI 投顾工具帮你盯数据,它测的却是"能不能回答一个理财常识问题"。这两件事之间的距离,比任何评分都大。所以真正能帮你 避坑的不是榜单的排名,是榜单没测的那一段——而你恰恰要在那一段上做决定。
所以在看完榜单之后,还有一步不能省:拿你手上真实的一份材料,去试一到两个候选。
这一步的成本是半小时,收益是你会看到榜单永远不写的东西——它在你的材料上错在哪。数据是不是指得回原表、行业对比里的"据某券商"能不能搜到、你问它一个没有答案的问题它会不会承认。这三条一过,选型基本就能定。
这也是 autoclaw 在做的事——它不做"哪个 AI 更聪明"的判断,而是把"数字能不能指回原表"变成流程里的一步:材料读取把三张表的行名映射到同一套口径,每个数字带着出处跟你走到稿子里。可校验是它的终点,不是它的卖点。 这和榜单的逻辑正好相反:榜单把判断藏进评分,它把判断摊在你面前。
AI 金融工具哪个好:自己怎么测
如果你不想再被榜单牵着走,有一个办法:自己出一份最小的评测。不用测十款,测两款就够;不用测一个月,半天能做完。核心是四个动作——这一套也是 autoclaw 内部用来评 AI 金融工具的办法,不是秘方,是工序。
一、定一个你每周都要做的活。 不是"让它分析财报"这种大词,是"从这份季报里读出营收、毛利率、经营现金流三个数,并对上上年同期"。任务越具体,结论越能用。
二、用同一份材料、同一句话问两个工具。 材料必须是你手上的真材料,别用示例数据——示例数据是给演示准备的,出不了错。
三、把两次原始回答原样留下来。 不整理、不润色、不删掉它答错的部分。这份记录是整件事的全部价值所在,丢了就等于没测。autoclaw 的材料读取做的也是这件事:取数的结果连着出处一起留下,不另存一份"漂亮版"。
四、只评一件事:它的数字能不能核。 两个 AI 工具比高低,不问"哪个更聪明",只问"它给的这个数,我能不能在三分钟内指回原表的那一行"。能,就是可用;不能,分数再高也没用。
四步做完,你会得到一份只有两款产品的小表,和一句任何榜单都给不了你的结论:在我这份活上,它错在哪里。
常见问题
AI 金融工具排行榜可信吗?
不能整体判断,只能逐份判断。看四件事:作者是谁、跟什么比、能不能复现、有没有说"不适合谁"。其中"能不能复现"最关键——它要求榜单交出原始提问或原始输出。一份榜单如果连"我们问了什么"都不给,它的分数就只是一个自称。
AI 金融工具哪个好?
没有通用答案,因为它取决于你要做的活。可行的做法是:用榜单缩小到两个候选,然后拿你手上真实的一份材料、同一个问题问这两款,只看一件事——数字能不能在几分钟内指回原表。能,就是可用。这一步没有替代品。
AI 投研工具评测里的准确率数字能信吗?
先看三件事:样本量、测试集是什么内容、方法是否公开。三样都有,这个数字可以作为参考;三样都没有,按不存在处理。同一份材料,换一个测试集,准确率可以差出二三十个百分点——口径不写,数字就没有意义。
为什么同一款工具,在不同榜单里排名差很多?
多数情况不是谁测得细,是每份榜单的资料来源不同:哪篇文章先被搜到、被引用得多,哪个产品就在那张表里靠前。这不涉及说谎,但它说明排名的来源是"被提到多少次",不是"被验证过多少次"。
AI 金融工具靠谱吗?
不能一刀切。靠谱的不是工具,是"你能不能验它"。一个 AI 金融工具靠不靠谱,不取决于它的参数多大、品牌多响,取决于它给的每一个数你能不能在三分钟内指回原表。能指回去的,就是靠谱的起点;指不回去的,它再流畅也不算靠谱。这也是为什么榜单替你回答不了这个问题——榜单测的不是你的材料。
AI 工具评测是不是软文?怎么区分?
有些是,有些不是。区分的办法只有一个:看它有没有交出原始输出。 软文和评测在版面上几乎一样——都有表格、有评分、有"实测"。但软文永远不会给你看测试过程的原始截图,因为它没有这个过程。如果一篇文章通篇是优点、缺点写成"还有提升空间"、评分不给权重说明,它大概率是甲方出过钱的。另一个信号是看署名:只有品牌名、没有作者名的,要格外警惕。
AI 选股工具准不准?
这个问题的答案不在"准不准"三个字上,在"它选的是什么"上。大多数 AI 选股工具做的事情是筛——从全市场按财务指标筛出一批,这一步可以做得不错。但从"筛出来"到"能买"之间,还隔着估值判断、行业周期、持仓集中度,这些它不做,或者做得很差。所以准确率这个数如果没写清测试集是什么(哪些票、持有多久、用什么基准),就没有意义。一个更实际的问题不是"它准不准",是"它筛出来的那批,你敢不敢自己再过一遍"。
AI 金融工具,能替代我自己做分析吗?
不能替代,可以分担。整理、取数、成稿这些有可校验终点的环节可以交出去——autoclaw 的材料读取做的正是这一段:三张表的行名映射到同一套口径,数字带着出处走到稿子里,错了跟原表一对就知道。判断和署名留在自己这一侧——这条线具体怎么划,见[哪些活能交给 AI,哪些不能](index.html#05)。分层的依据是"错了能不能被发现",不是"它有多聪明"。
最后
榜单的麻烦不在于它错,在于它看起来像证据。一份带评分、带雷达图、带"实测三十天"的横评,和一份真的做过测试的记录,在版面上几乎分不出来。真正分开它们的是四句话:谁写的、跟什么比、能不能复现、有没有说"不适合谁"。这四句话不需要专业知识就能问,也正因为如此,没有人有理由替你跳过。
能用榜单做的事,缩小范围;不能交给榜单做的事,判断它在你的活上对不对。 后一件事,只能你自己拿材料去试。它也正好是唯一一件,别人替你做不了、也抄不走的事。
autoclaw 站在这条线的可校验一侧:材料读取、取数、成稿、定时交付——每一道都有对得上的原表、留得下的出处。判断和署名不在它的边界内。所以这篇不替你选工具,只替你把"怎么选"这件事说清楚。选型终点的最后一句话,仍然要你自己签。


